Startseite
» Nachrichten
»
Falscher Geheimdienstbericht der US-Militär-KI: Was geschah und warum ist es wichtig?
Falscher Geheimdienstbericht der US-Militär-KI: Was geschah und warum ist es wichtig?
Ein Bericht über einen Beinahe-Unfall des US-Militärs im Zusammenhang mit einem KI-gestützten Geheimdienstbericht hat sich zu einer aufschlussreichen Fallstudie für ein viel umfassenderes Problem entwickelt: Generative KI kann Analysen zwar beschleunigen, doch Geschwindigkeit ist nicht gleichbedeutend mit verifizierter Genauigkeit. In kritischen Situationen kann eine perfekt ausgearbeitete Antwort gefährlich sein, wenn ihre Quellen, Annahmen und Unsicherheiten für die darauf basierenden Entscheidungsträger nicht transparent sind.
Laut einem CNN-Bericht vom 18. September 2026 , der sich auf vier mit dem Vorgang vertraute Personen beruft, kursierte während des Iran-Krieges innerhalb des US-Militärs ein Geheimdienstbericht. Dieser behauptete, ein chinesisches Schiff im Nahen Osten transportiere Komponenten eines Atomwaffenprogramms. CNN berichtete weiter, dass Vorbereitungen zur Abfangung des Schiffes getroffen und Militärflugzeuge bereits in der Luft gewesen seien, bevor die Verantwortlichen die zugrundeliegende Analyse erneut prüften.
Die Überprüfung ergab dem Bericht zufolge, dass ein Chatbot die Ladung des Schiffes falsch identifiziert hatte. CNN berichtete außerdem, dass KI erneut eingesetzt wurde, um die Analyse in ein standardisiertes Geheimdienstberichtsformat zu bringen. Dieser zweite Schritt ist wichtig, da eine autoritative Formatierung schwache Analysen vertrauenswürdiger erscheinen lassen kann, als sie tatsächlich sind.
Es gibt wichtige Grenzen dessen, was öffentlich bekannt ist. CNN gab an, nicht feststellen zu können, um welche Art von Fracht es sich bei der falsch identifizierten Ladung handelte oder ob der Chatbot ein kommerzielles System oder ein Regierungsprodukt war. Das Pentagon und das US Special Operations Command Pacific reagierten nicht auf CNNs Bericht. Zum Zeitpunkt dieses Berichts handelte es sich daher um einen bestätigten Nachrichtenbericht und nicht um einen öffentlich zugänglichen Untersuchungsbericht oder Einsatzbericht des Verteidigungsministeriums.
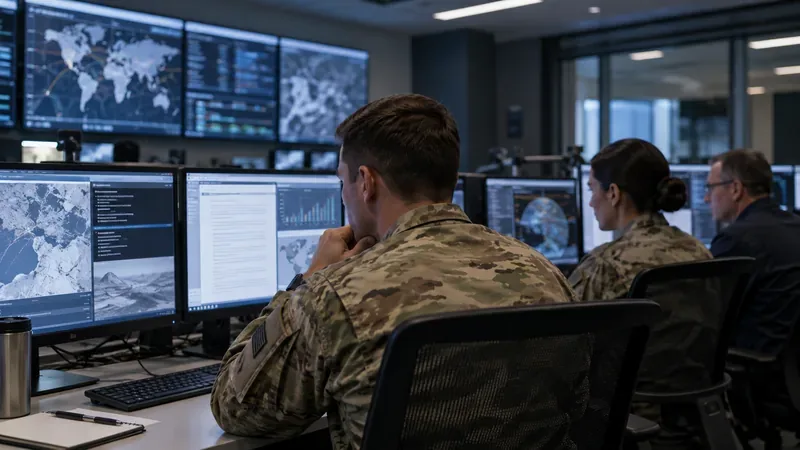
Militäranalysten arbeiten an Computerarbeitsplätzen in einer typischen Operationszentrale; das Bild dient der Kontextualisierung der maschinengestützten Analyse durch einen Menschen und stellt nicht den gemeldeten Vorfall dar.
Warum der gemeldete Vorfall von Bedeutung ist
Die unmittelbare Sorge besteht nicht nur darin, dass ein KI-System eine falsche Aussage generiert haben könnte. Generative KI-Systeme sind dafür bekannt, überzeugend klingende, aber unbegründete Ergebnisse zu erzeugen – ein Risiko, das das Nationale Institut für Standards und Technologie (NIST) unter dem Oberbegriff „Konfabulation“ zusammenfasst. Das NIST- Profil für generative KI betrachtet dies als ein Risiko, das Organisationen aktiv messen und managen sollten, anstatt es einfach zu eliminieren.
Ein schwerwiegenderes Versagen tritt ein, wenn eine generierte Behauptung ohne ausreichende Prüfung durch eine Institution gelangt. Wird die Antwort des Systems in ein bekanntes Informationsformat umgewandelt, über vertrauenswürdige Kanäle verbreitet und ohne unabhängige Bestätigung umgesetzt, kann die Unsicherheit des Modells verschwinden, während die institutionelle Autorität des Dokuments steigt.
Geschwindigkeit kann die für Skepsis verfügbare Zeit verkürzen.
Militärische Organisationen legen aus nachvollziehbaren Gründen Wert auf schnelle Entscheidungen. Die Strategie des US-Verteidigungsministeriums zur Einführung von Daten, Analysen und künstlicher Intelligenz (2023) verknüpft KI explizit mit schnelleren und besseren Entscheidungen und räumt gleichzeitig der Gewährleistung und verantwortungsvollen Nutzung von KI hohe Priorität ein. Diese Ziele sind jedoch nur dann vereinbar, wenn eine schnellere Entwicklung mit einer ausreichend strengen Verifizierung einhergeht.
Ein sinnvoller Qualitätstest ist daher nicht „Wie schnell hat die KI die Bewertung erstellt?“, sondern „Wie schnell könnte ein Prüfer jeden betrieblich relevanten Anspruch überprüfen?“ Wenn die Überprüfungszeit steigt, während die Erstellungszeit sinkt, mag der Arbeitsablauf zwar effizient erscheinen, tatsächlich werden aber Arbeit und Risiken nachgelagert verlagert.
Quellcodefusion kann den Ursprung eines Fehlers verschleiern.
CNN berichtete, dass der Chatbot öffentlich zugängliche Informationen mit geheimdienstlichen Daten kombinierte. Solche Synthesen können zwar wertvoll sein, werfen aber auch ein Problem der Quellennachverfolgung auf. Ein Gutachter muss wissen, welche Schlussfolgerung aus welcher Quelle stammt, was direkt beobachtet, was abgeleitet und was vom Modell generiert wurde.
Wenn diese Unterscheidungen zu einer einzigen, flüssigen Erzählung verschmelzen, kann der Rezensent möglicherweise nicht mehr erkennen, ob ein Schlüsselsatz auf einer Rohinformation, einer menschlichen Analyse oder einer KI-generierten Schlussfolgerung beruht. Dies ist besonders gefährlich, wenn die Behauptung eine irreversible Maßnahme auslösen könnte.
Was ein hochwertiger KI-gestützter Workflow für intelligente Prozesse leisten sollte
Die angemessenste Reaktion auf einen solchen Fehler ist nicht die pauschale Aussage, KI sei immer unsicher. Ein besserer Ansatz ist die Definition beobachtbarer Qualitätsmerkmale. Die folgenden Prüfungen erleichtern die Überprüfung der Ergebnisse und machen deutlicher, wann der Workflow angepasst werden muss.
Qualitätskriterium
Wie sieht ein gutes Aussehen aus?
Warnschild
Wann sollte man die Vorgehensweise ändern?
Herkunft
Jeder betrieblich relevante Anspruch lässt sich auf benannte Quelldatensätze, Zeitstempel oder Erfassungsströme zurückführen.
Der Rezensent sieht eine Schlussfolgerung, kann aber die ihr zugrunde liegenden Beweise nicht identifizieren.
Verwenden Sie für diese Behauptung keine Freitextgenerierung mehr, sondern wechseln Sie zur quellenbasierten Recherche oder manuellen Überprüfung.
Unabhängige Bestätigung
Aussagen mit hoher Relevanz werden anhand einer separaten Quelle oder eines separaten Analyseverfahrens überprüft.
Mehrere Sätze stammen alle aus demselben Modelloutput oder derselben zugrunde liegenden Quelle.
Die Maßnahmen sollten bis zum Vorliegen einer unabhängigen Überprüfung verzögert werden, es sei denn, ein Kommandeur akzeptiert das Restrisiko ausdrücklich gemäß den geltenden Regeln.
Unsicherheit
Der Bericht unterscheidet zwischen beobachteten Fakten, Einschätzungen von Analysten, Modellschlussfolgerungen und ungelösten Fragen.
Die Sprache ist eindeutig, selbst wenn die Beweislage uneindeutig ist.
Vor der weiteren Verbreitung sollten eine Vertraulichkeitserklärung und alternative Erklärungen gefordert werden.
Menschliche Herausforderung
Von einem Gutachter wird erwartet, dass er die Schlussfolgerung prüft und nicht lediglich die Formatierung genehmigt.
Die Rolle des Menschen reduziert sich darauf, bei einem von einer KI erstellten Produkt auf „Akzeptieren“ zu klicken.
Bei Entscheidungen mit weitreichenden Konsequenzen sollte ein zweiter Prüfer oder ein Red-Team-Check hinzugezogen werden.
Prüfbarkeit
Eingabeaufforderungen, Modellversion, abgerufene Nachweise, Bearbeitungen und endgültige Genehmigungen werden protokolliert.
Niemand kann rekonstruieren, wie diese Schlussfolgerung zustande kam.
Das Produkt ist bis zur Wiederherstellung der Lieferkette als ungeeignet für den operativen Einsatz in risikoreichen Bereichen zu betrachten.
Die bestehenden US-Verteidigungsgrundsätze deuten bereits auf diese Kontrollmechanismen hin.
Die ethischen Grundsätze des US-Verteidigungsministeriums für KI sind relevant, da sie menschliche Verantwortung, Nachvollziehbarkeit, Zuverlässigkeit und Steuerbarkeit betonen. Das Implementierungsmemorandum des Ministeriums aus dem Jahr 2021 legt fest, dass Mitarbeiter angemessene Sorgfalt walten lassen sollen, dass KI-Methoden und Datenquellen für die relevanten Mitarbeiter transparent und überprüfbar sein müssen und dass die Fähigkeiten innerhalb ihrer definierten Anwendungsbereiche getestet und sichergestellt werden müssen. Das Quelldokument ist das Memorandum des US-Verteidigungsministeriums zur Implementierung verantwortungsvoller künstlicher Intelligenz .
Für autonome und teilautonome Waffensysteme fordert die DoD-Direktive 3000.09 angemessene menschliche Beurteilung, realistische Tests, Robustheit sowie transparente oder nachvollziehbare Datenquellen und -technologien. Diese Direktive regelt nicht per se jeden Chatbot für die Geheimdienstanalyse und sollte daher nicht als Beweis dafür herangezogen werden, dass der gemeldete Arbeitsablauf gegen eine bestimmte Waffenrichtlinie verstoßen hat. Sie dient jedoch weiterhin als Beleg für die allgemeine Sicherheitslogik des Ministeriums: Systeme, die weitreichende Entscheidungen beeinflussen, benötigen definierte Grenzen, Tests, Aufsicht und eine Möglichkeit, sie zu stoppen, wenn ihr Verhalten nicht vertrauenswürdig ist.
Wann sollten Organisationen aufhören, ein generatives Modell zu verwenden und die Methode wechseln?
Eine praxisorientierte KI-Richtlinie sollte klare Ausstiegsbedingungen enthalten. Teams sollten von der uneingeschränkten Generierung von Daten absehen, wenn das System keine verlässliche Quellenherkunft nachweisen kann, wenn eine Behauptung den Einsatz von Gewalt direkt beeinflussen könnte, wenn das Modell die Identität oder den Zweck von unklarer Fracht oder Ausrüstung ableiten soll oder wenn Gutachter die Schlussfolgerung anhand der zugrunde liegenden Beweise nicht reproduzieren können.
In solchen Fällen kann ein reines Abrufsystem, das relevante Quelltextpassagen ohne Generierung neuer Schlussfolgerungen liefert, eine sicherere Alternative darstellen. Eine weitere Möglichkeit ist die strukturierte Entscheidungsunterstützung, bei der das Modell zwar Beweise ordnet, aber keine fehlenden Fakten ergänzen darf. Bei besonders wichtigen Fragestellungen kann die herkömmliche menschliche Analyse mit maschineller Unterstützung, beschränkt auf Suche, Übersetzung, Transkription oder Dokumentensichtung, die angemessene Methode sein.
Der richtige Schwellenwert hängt von den Folgen eines Fehlers ab. Ein Modell zur Zusammenfassung eines Logistikmemos kann ein anderes Maß an Restunsicherheit tolerieren als ein Modell, dessen Ergebnisse eine Entscheidung über eine Abfangmaßnahme, einen Streik oder eine Eskalation beeinflussen können.
Wie man beurteilt, ob Schutzmaßnahmen tatsächlich funktionieren
Richtlinien allein genügen nicht, wenn Organisationen ihre Ergebnisse nicht messen. Nützliche Indikatoren sind beispielsweise der Anteil wirkungsvoller Aussagen mit direkten Quellenangaben, die Häufigkeit, mit der Gutachter unbegründete Modellbehauptungen finden, die Anzahl der nach ihrer Veröffentlichung zurückgezogenen oder korrigierten Berichte, die durchschnittliche Zeit, die zur Überprüfung kritischer Aussagen benötigt wird, und wie oft KI-Empfehlungen nach einer unabhängigen Begutachtung geändert werden.
Ein weiteres wichtiges Signal ist Uneinigkeit. Wenn ein zweiter Analyst oder ein anderes Modell aus denselben Daten zu einer wesentlich anderen Interpretation gelangt, sollte dies zu einer genaueren Prüfung führen, anstatt automatisch einen Mittelwert zu bilden. Uneinigkeit kann Unklarheiten aufdecken, die eine eindeutige, einheitliche Antwort sonst verbergen würde.
Die Qualität sollte auch unter realistischen Bedingungen beurteilt werden. Ein Arbeitsablauf, der im Labor gut funktioniert, aber versagt, wenn Analysten unter Zeitdruck stehen, überlastet sind oder mit unvollständigen Informationen arbeiten, ist für den operativen Einsatz mit weitreichenden Folgen ungeeignet. Der relevante Test ist das gesamte Mensch-Maschine-System, nicht das isolierte Modell.
Was diese Episode nicht beweist
Der gemeldete Beinahe-Unfall beweist weder, dass alle militärischen KI-Systeme unzuverlässig sind, noch dass generative KI grundsätzlich nicht für nachrichtendienstliche Zwecke eingesetzt werden sollte, noch dass ein bestimmter Modellanbieter das Problem verursacht hat. Die öffentliche Meldung nennt weder das Modell noch die genaue Aufgabenstellung, die falsch identifizierte Fracht, den vollständigen Prüfablauf oder die für den Analysten geltenden internen Richtlinien.
Es wird auch nicht ermittelt, wie häufig ähnliche Fehler auftreten. Ohne eine öffentliche Vorfallsdatenbank, Prüfergebnisse oder eine offengelegte Kennzahl, die die Anzahl der erstellten KI-gestützten Analyseprodukte angibt, lässt sich aus einem einzelnen Vorfall keine verlässliche Fehlerrate ableiten.
Diese Grenzen sind wichtig, da Überreaktionen genauso kontraproduktiv sein können wie Unterreaktionen. Die schlüssigere Lehre ist klarer: Wird KI in einen Analyseprozess mit weitreichenden Folgen integriert, sollte die Qualität der Ergebnisse anhand von Herkunft, Bestätigung, Umgang mit Unsicherheiten, Reproduzierbarkeit und unabhängiger menschlicher Überprüfung beurteilt werden – nicht anhand von flüssiger Verarbeitung, Geschwindigkeit oder professionell aussehender Formatierung.
Fazit
Der gemeldete Vorfall mit falschen Geheimdienstinformationen durch KI des US-Militärs ist deshalb von Bedeutung, weil er einen Fehlermodus veranschaulicht, der in jeder Organisation mit hohem Einsatz auftreten kann: Ein Modell trifft eine unbegründete Schlussfolgerung, eine Software macht aus dieser Schlussfolgerung ein ausgereiftes Produkt, und institutionelle Prozesse beginnen, das Produkt so zu behandeln, als ob seine Autorität auf verifizierten Beweisen beruhen würde.
Das praktische Ziel ist nicht, generative KI fehlerfrei zu machen. Aktuelle Systeme können dies nicht garantieren. Ziel ist es vielmehr, den Workflow so zu gestalten, dass ein KI-Fehler ein erkennbarer Entwurfsfehler bleibt und nicht zum operativen Ergebnis wird. Die deutlichsten Anzeichen für ein ausgereiftes System sind die nachvollziehbare Herkunft der Daten, die unabhängige Bestätigung wichtiger Aussagen, die explizite Angabe von Unsicherheiten, protokollierte Prüfschritte und ein vordefinierter Punkt, an dem Menschen dem generierten Pfad nicht mehr vertrauen und auf eine präzisere Methode umsteigen.