Inicio
» Noticias
»
Qué es RAG en inteligencia artificial y cómo mejora las respuestas de un asistente
Qué es RAG en inteligencia artificial y cómo mejora las respuestas de un asistente
Cuando un asistente responde sobre una política interna, un manual o un catálogo, el conocimiento general del modelo puede no bastar: quizá esos datos no formaban parte de su entrenamiento o ya cambiaron. La generación aumentada por recuperación, conocida por las siglas inglesas RAG (Retrieval-Augmented Generation), añade una búsqueda de información pertinente antes de generar la respuesta. Así, el modelo puede apoyarse en documentos seleccionados para la consulta en vez de depender únicamente de lo que aprendió durante el entrenamiento.
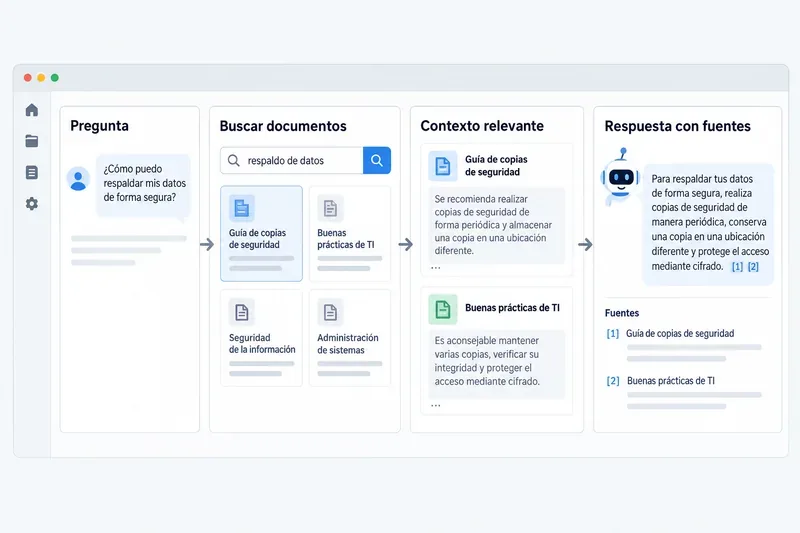
Esquema conceptual del recorrido RAG: la consulta activa una búsqueda, los documentos pertinentes aportan contexto y la respuesta puede incluir referencias.
Qué significa RAG y qué hace
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. Es un patrón de diseño para combinar un sistema de búsqueda con un modelo generativo de lenguaje. La búsqueda localiza información en una colección de fuentes; el modelo usa el material recuperado junto con la pregunta para redactar una respuesta en lenguaje natural. El artículo de investigación de Lewis y otros presentó una formulación temprana de este enfoque en 2020, combinando memoria paramétrica del modelo con una memoria documental externa. Las implementaciones actuales varían, pero conservan esta idea central.
En la práctica, la colección puede incluir documentos de empresa, páginas de ayuda, manuales, bases de datos o contenido autorizado de una web. La colección disponible depende de cómo se haya construido el asistente: “RAG” por sí solo no significa que tenga acceso a Internet, a todos los archivos de una organización ni a información en tiempo real. Para quien evalúa una herramienta, la acción útil es preguntar qué fuentes consulta, quién las mantiene y cuándo se actualizan.
Cómo funciona una consulta con RAG
Preparación de las fuentes. El sistema incorpora documentos y extrae su contenido. A menudo los divide en fragmentos para recuperar una sección concreta sin enviar un archivo entero al modelo. Los fragmentos pueden conservar metadatos como título, fecha, categoría o permisos.
Indexación. La aplicación organiza esos fragmentos en un índice que permite encontrarlos después. Algunas soluciones crean representaciones numéricas llamadas embeddings, que aproximan relaciones de significado entre textos; otras combinan búsqueda semántica con búsqueda por palabras clave. No existe un único índice obligatorio para todo RAG.
Recuperación. Al recibir una pregunta, el buscador localiza los fragmentos que parecen más útiles. El sistema puede reformular una consulta, filtrar por fecha o permisos, o volver a ordenar los resultados para priorizar los más relevantes.
Contexto y generación. La aplicación pasa al modelo la pregunta y una selección de fragmentos. El modelo redacta una respuesta usando ese contexto, y la interfaz puede mostrar las fuentes para que la persona las revise.
En una base de conocimiento de soporte técnico, por ejemplo, alguien pregunta cómo restablecer un equipo. El asistente podría recuperar el apartado pertinente del manual vigente y resumirlo en pasos breves. Si recupera un documento de otro modelo de equipo, una versión antigua o una sección incompleta, la respuesta todavía puede fallar. Conviene comprobar que la referencia mostrada abre el documento correcto y coincide con la versión del producto.
El esquema general de ingesta, división en fragmentos, generación de embeddings, indexación, recuperación y generación aparece en la documentación de Google Cloud sobre RAG Engine. La guía de arquitectura de Microsoft Azure también describe el flujo y subraya que hay que evaluar cada fase.
Qué puede mejorar y de qué depende
Información específica: el modelo puede consultar datos propios que no conoce por su entrenamiento. Esto resulta útil para preguntas sobre políticas, productos o procedimientos internos. Compruebe que esas fuentes se han incluido y que la búsqueda recupera el apartado adecuado.
Actualización más sencilla: una organización puede actualizar documentos o el índice sin volver a entrenar necesariamente el modelo base. Sin embargo, la actualización solo llega al asistente cuando el contenido nuevo se ingiere y la indexación termina correctamente. Pregunte cuándo se sincronizó la colección.
Respuestas más verificables: el producto puede adjuntar referencias o fragmentos de origen. Esto facilita revisar una afirmación, pero RAG no garantiza que haya citas visibles ni que una cita respalde cada frase. Abra la fuente y compare el pasaje con la respuesta.
Menos respuestas desligadas de la fuente: proporcionar contexto pertinente puede reducir algunas invenciones. No elimina alucinaciones: el modelo puede malinterpretar un texto, combinar fuentes incompatibles o contestar con seguridad aunque el contexto no contenga la respuesta. Pruebe preguntas cuya respuesta se conoce y revise tanto el contenido recuperado como el texto generado.
Google describe RAG como una técnica de fundamentación que añade información recuperada a la instrucción del modelo y advierte que datos incorrectos o incompletos pueden producir salidas deficientes. Por eso, la mejora no se deduce solo de activar una función: hay que comparar resultados con consultas reales y fuentes de referencia.
Malentendidos frecuentes: qué está confirmado y qué depende
Afirmación
Qué se puede afirmar
Qué hacer
“RAG elimina las alucinaciones”.
No. Aporta contexto recuperado, pero la respuesta aún puede desviarse de ese contexto o de la realidad.
Compruebe las fuentes y mida errores con preguntas de prueba.
“RAG siempre busca en Google o en Internet”.
No necesariamente. Busca en las fuentes conectadas a la aplicación; la web pública solo estará disponible si se integra y configura.
Revise la lista de fuentes y el alcance de acceso del asistente.
“Todos los RAG usan una base vectorial”.
Depende de la arquitectura. La búsqueda vectorial es habitual, pero puede combinarse con búsqueda textual, filtros y otros métodos.
Pregunte cómo se recuperan los documentos y pruebe consultas con nombres exactos y preguntas semánticas.
“Si muestra una cita, la respuesta está demostrada”.
Una referencia ayuda a rastrear el origen, pero su presencia no prueba por sí sola que respalde la afirmación completa.
Abra el pasaje citado y verifique que realmente contesta lo preguntado.
“RAG actualiza el conocimiento del modelo”.
Normalmente incorpora contexto recuperado en cada consulta; no equivale a cambiar los parámetros entrenados del modelo.
Para datos recientes, confirme la actualización de la fuente y del índice, no solo la fecha de entrenamiento del modelo.
El trabajo original de RAG también planteaba que la memoria externa permite actualizar el conocimiento y aporta procedencia, pero eso no implica que todas las aplicaciones comerciales implementen esas propiedades de la misma manera. La capacidad concreta depende del índice, las reglas de acceso, la interfaz y la lógica de respuesta. Consulte la publicación original de RAG para el alcance de la propuesta académica.
Límites que conviene comprobar
La calidad de la búsqueda depende de la calidad de la colección. Documentos desactualizados, duplicados, mal extraídos o con tablas difíciles de interpretar pueden conducir a respuestas parciales. También importa cómo se dividen: fragmentos demasiado pequeños pueden perder contexto; fragmentos demasiado grandes pueden incluir texto irrelevante o exceder el espacio disponible en la solicitud. La guía de Microsoft detalla estos compromisos de fragmentación; la opción adecuada cambia con el tipo de documento y la consulta.
Además, si los permisos no se aplican en la recuperación, el sistema podría exponer contenido a una persona que no debería verlo. En una aplicación empresarial, averigüe cómo se respetan los permisos de usuario, cómo se actualizan las fuentes y qué registros quedan de las consultas. No cargue información sensible en una herramienta sin confirmar antes sus condiciones y controles de datos.
Por último, RAG puede aumentar latencia y coste porque incorpora búsqueda y preparación de contexto. La compensación puede valer la pena en consultas que requieren información concreta y revisable; para una tarea sencilla de redacción o ideación, añadir recuperación quizá no aporte una mejora perceptible. Compare el tiempo, coste y calidad con el mismo conjunto de preguntas en ambos escenarios.
Cómo evaluar si mejora un asistente
Reúna preguntas habituales, preguntas con datos recientes, consultas ambiguas y casos cuya respuesta no aparezca en las fuentes.
Para cada consulta, anote cuál sería una respuesta correcta y qué documento la respalda.
Compruebe si la búsqueda encuentra los pasajes esperados antes de juzgar la redacción del modelo.
Revise si la respuesta es pertinente, completa y coherente con los pasajes recuperados; incluya errores de cita y casos en los que debería reconocer que falta información.
Repita la evaluación cuando cambien los documentos, el índice, el modelo o las instrucciones del asistente.
Microsoft distingue en su documentación de evaluación la calidad de la recuperación, la fundamentación de la respuesta, su relevancia y su completitud: son preguntas diferentes. Esa separación ayuda a localizar si el problema viene del buscador o del generador. Como comprobación rápida para un usuario final, pida la fuente, siga la referencia, compare su fecha y contenido y reformule la consulta si la respuesta mezcla temas.
En resumen
RAG conecta un modelo generativo con una búsqueda sobre fuentes elegidas y le aporta fragmentos pertinentes para responder. Puede hacer que un asistente sea más útil con documentación propia o cambiante y facilitar la verificación. No garantiza exactitud, actualidad, acceso web ni citas fiables por sí mismo: todo eso depende de los datos, la recuperación, los permisos y el diseño de la aplicación. Antes de confiar en un asistente RAG, compruebe qué consulta, qué encontró y si la respuesta está respaldada por la fuente.