Início
» Notícias
»
Relatório de Inteligência Artificial das Forças Armadas dos EUA sobre Inteligência Artificial Falsa: O que aconteceu e por que isso importa
Relatório de Inteligência Artificial das Forças Armadas dos EUA sobre Inteligência Artificial Falsa: O que aconteceu e por que isso importa
Um incidente envolvendo militares dos EUA que quase resultou em tragédia, envolvendo um relatório de inteligência assistido por IA, tornou-se um estudo de caso útil para um problema muito mais amplo: a IA generativa pode acelerar as análises, mas velocidade não é sinônimo de precisão comprovada. Em um cenário de alto risco, uma resposta impecável pode ser perigosa se suas fontes, suposições e incertezas não forem transparentes para as pessoas que a utilizam.
Segundo a reportagem original da CNN de 18 de setembro de 2026 , citando quatro pessoas familiarizadas com o episódio, um relatório de inteligência circulou dentro das forças armadas dos EUA durante a guerra com o Irã, alegando que um navio chinês no Oriente Médio transportava componentes relacionados a um programa de armas nucleares. A CNN informou que preparativos foram feitos para interceptar a embarcação e que aeronaves militares já estavam no ar antes que as autoridades reexaminassem a análise subjacente.
A investigação concluiu que um chatbot identificou incorretamente a carga do navio. A CNN também informou que a inteligência artificial foi usada novamente para formatar a análise em um formato padrão de relatório de inteligência. Essa segunda etapa é importante porque uma formatação formal pode fazer com que análises superficiais pareçam mais confiáveis do que realmente são.
Existem limites importantes para o que é de conhecimento público. A CNN afirmou não ter conseguido determinar qual era a carga erroneamente identificada, nem se o chatbot era um sistema comercial ou um produto governamental. O Pentágono e o Comando de Operações Especiais dos EUA no Pacífico não responderam à CNN sobre a reportagem. Portanto, até o momento da publicação desta matéria, o episódio era, na verdade, uma notícia baseada em fontes, e não uma investigação ou relatório pós-ação divulgado publicamente pelo Departamento de Defesa.
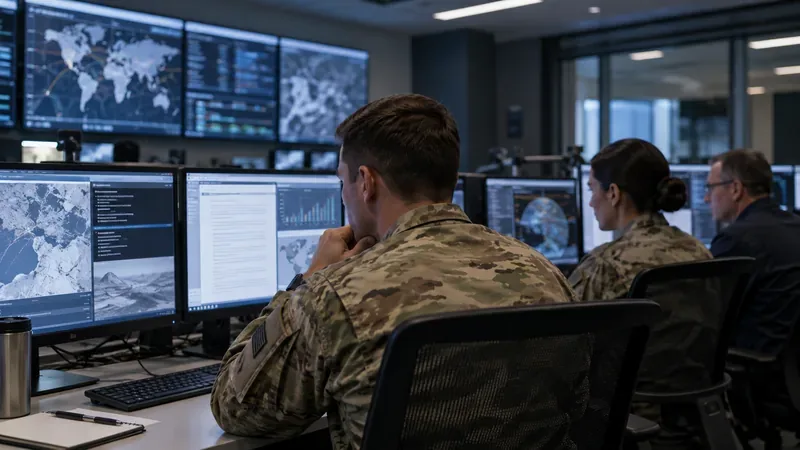
Analistas militares trabalham em estações de computador em um ambiente genérico de centro de operações; a imagem fornece contexto para a revisão humana da análise assistida por máquina e não retrata o incidente relatado.
Por que o incidente relatado é importante?
A preocupação imediata não é simplesmente que um sistema de IA possa ter produzido uma declaração falsa. Sabe-se que sistemas de IA generativa produzem resultados que soam confiantes, mas sem embasamento, um risco que o Instituto Nacional de Padrões e Tecnologia (NIST) descreve na categoria mais ampla de confabulação. O Perfil de IA Generativa do NIST trata isso como um risco que as organizações devem medir e gerenciar ativamente, em vez de presumir que possa ser eliminado.
A falha mais consequente ocorre quando uma alegação gerada transita por uma instituição sem a devida análise. Se a resposta do sistema for convertida em um formato de inteligência familiar, distribuída por canais confiáveis e utilizada antes de uma confirmação independente, a incerteza do modelo pode desaparecer enquanto a autoridade institucional do documento aumenta.
A velocidade pode comprimir o tempo disponível para o ceticismo.
Um teste de qualidade útil, portanto, não é "Com que rapidez a IA gerou a avaliação?", mas sim "Com que rapidez um revisor poderia verificar cada afirmação operacionalmente significativa?". Se o tempo de verificação aumentar enquanto o tempo de redação diminuir, o fluxo de trabalho pode parecer eficiente, embora, na realidade, esteja transferindo trabalho e risco para etapas posteriores.
A fusão de fontes pode ocultar onde um erro começou.
A CNN noticiou que o chatbot combinou material de código aberto com informações confidenciais de inteligência de sinais. Esse tipo de síntese pode ser valioso, mas também cria um problema de proveniência. Um revisor precisa saber qual conclusão veio de qual fonte, o que foi observado diretamente, o que foi inferido e o que foi gerado pelo modelo.
Quando essas distinções são reduzidas a uma única narrativa fluida, o revisor pode não conseguir determinar se uma frase-chave reflete um dado bruto de inteligência, um julgamento analítico humano ou uma inferência produzida por IA. Isso é especialmente perigoso quando a afirmação pode desencadear uma ação irreversível.
O que um fluxo de trabalho de inteligência assistida por IA de alta qualidade deve produzir
A resposta mais eficaz a uma falha como essa não é a regra geral de que a IA é sempre insegura. Uma abordagem melhor é definir pontos de controle de qualidade observáveis. As verificações a seguir facilitam a auditoria dos resultados e deixam mais claro quando o fluxo de trabalho precisa ser alterado.
Critério de qualidade
O que é bom
Sinal de aviso
Quando mudar a abordagem
Proveniência
Cada reivindicação operacionalmente significativa pode ser rastreada até registros de origem nomeados, carimbos de data/hora ou fluxos de coleta.
O revisor vê uma conclusão, mas não consegue identificar as evidências que a sustentam.
Pare de usar a geração de dados em formato livre para essa afirmação e passe a usar a recuperação baseada em fontes ou a revisão manual.
Corroboração independente
Alegações de alto impacto são verificadas em uma fonte ou caminho analítico separado.
Várias frases derivam da mesma saída do modelo ou da mesma fonte subjacente.
Adiar a ação até que uma verificação independente esteja disponível, a menos que o comandante aceite explicitamente o risco residual de acordo com as regras existentes.
Incerteza
O relatório separa os fatos observados, as avaliações dos analistas, as inferências dos modelos e as questões não resolvidas.
A linguagem é definitiva mesmo quando as evidências são ambíguas.
Exija uma declaração de confidencialidade e explicações alternativas antes de qualquer divulgação adicional.
Desafio humano
Espera-se que um revisor teste a conclusão, e não apenas aprove a formatação.
O papel do ser humano se resume a clicar em "aceitar" em um produto elaborado por inteligência artificial.
Para decisões de alto impacto, considere a inclusão de um segundo revisor ou uma equipe de segurança dedicada (red team).
Auditabilidade
Os prompts, a versão do modelo, as evidências recuperadas, as edições e as aprovações finais são registrados.
Ninguém consegue reconstruir como se chegou a essa conclusão.
Considere o produto inadequado para uso operacional de alto risco até que a cadeia possa ser reconstruída.
Os princípios de defesa existentes nos EUA já apontam para esses controles.
Os princípios éticos de IA do Departamento de Defesa são relevantes porque enfatizam a responsabilidade humana, a rastreabilidade, a confiabilidade e a governabilidade. O memorando de implementação do departamento, de 2021, afirma que o pessoal deve exercer julgamento e cuidado apropriados, que as metodologias de IA e as fontes de dados devem ser transparentes e auditáveis para o pessoal relevante e que as capacidades devem ser testadas e asseguradas dentro de seus usos definidos. O documento original é o memorando do Departamento de Defesa sobre a implementação da Inteligência Artificial Responsável .
Para sistemas de armas autônomos e semiautônomos, a Diretiva 3000.09 do Departamento de Defesa exige julgamento humano apropriado, testes realistas, robustez e fontes de dados e tecnologias transparentes ou auditáveis. Essa diretiva, por si só, não rege todos os chatbots de análise de inteligência, portanto, não deve ser apresentada como prova de que o fluxo de trabalho relatado violou uma política de armas específica. Ela ainda é útil como evidência da lógica de segurança mais ampla do departamento: sistemas que influenciam decisões importantes precisam de limites definidos, testes, supervisão e uma maneira de interromper sua execução quando o comportamento não for confiável.
Quando as organizações devem parar de usar um modelo generativo e mudar de método?
Uma política prática de IA deve incluir condições de saída claras. As equipes devem abandonar a geração irrestrita quando o sistema não puder demonstrar a procedência confiável da fonte, quando uma alegação puder influenciar diretamente o uso da força, quando o modelo for solicitado a inferir a identidade ou a finalidade de cargas ou equipamentos ambíguos ou quando os revisores não puderem reproduzir a conclusão a partir das evidências subjacentes.
Nesses casos, uma alternativa mais segura pode ser um sistema de recuperação de informações que retorne trechos relevantes da fonte sem gerar uma nova conclusão factual. Outra opção é o suporte estruturado à decisão, no qual o modelo pode organizar as evidências, mas não pode preencher as lacunas de informação. Para as questões de maior impacto, o método apropriado pode ser simplesmente a análise humana convencional com auxílio de máquina limitado à busca, tradução, transcrição ou triagem de documentos.
O limiar adequado depende da consequência do erro. Um modelo usado para resumir um memorando de logística pode tolerar um nível de incerteza residual diferente de um modelo cujo resultado pode afetar uma decisão de interdição, greve ou escalada.
Como avaliar se as medidas de segurança estão realmente funcionando
As políticas não são suficientes a menos que as organizações mensurem os resultados. Indicadores úteis incluem a porcentagem de alegações de alto impacto com citações diretas de fontes, a taxa na qual os revisores encontram afirmações de modelo sem embasamento, o número de relatórios retirados ou corrigidos após a divulgação, o tempo médio necessário para verificar alegações críticas e a frequência com que as recomendações de IA são alteradas após revisão independente.
Outro sinal valioso é a discordância. Se um segundo analista ou um modelo separado chegar a uma interpretação substancialmente diferente a partir das mesmas evidências, isso deve aumentar o escrutínio, em vez de desencadear uma média automática. A discordância pode revelar ambiguidades que uma resposta única e categórica ocultaria.
A qualidade também deve ser avaliada sob pressão realista. Um fluxo de trabalho que apresenta bom desempenho em laboratório, mas falha quando os analistas estão com pressa, sobrecarregados ou trabalhando com informações incompletas, não está pronto para uso operacional em situações reais. O teste relevante é o sistema completo homem-máquina, e não o modelo isoladamente.
O que este episódio não prova
O incidente relatado não comprova que todos os sistemas de IA militar sejam falhos, que a IA generativa jamais deva ser usada em trabalhos de inteligência ou que um fornecedor específico de modelos tenha causado o problema. O relatório público não identifica o modelo, o comando exato, a carga mal identificada, toda a cadeia de revisão ou as regras internas que se aplicavam ao analista.
Além disso, não estabelece com que frequência erros semelhantes ocorrem. Sem um banco de dados público de incidentes, resultados de auditorias ou um denominador divulgado que mostre quantos produtos de inteligência assistida por IA são produzidos, um único episódio não pode sustentar uma taxa de falhas confiável.
Esses limites são importantes porque reagir de forma exagerada pode ser tão prejudicial quanto reagir de forma insuficiente. A lição mais defensável é mais específica: quando a IA é inserida em um fluxo de trabalho analítico de alto impacto, a qualidade do resultado deve ser avaliada pela proveniência, corroboração, tratamento da incerteza, reprodutibilidade e revisão humana independente — e não pela fluência, velocidade ou formatação com aparência profissional.
Resumindo
O episódio de falsa inteligência artificial (IA) relatado pelas forças armadas dos EUA é importante porque ilustra uma falha que pode ocorrer em qualquer organização de alto risco: um modelo faz uma inferência sem fundamento, o software transforma essa inferência em um produto refinado e os processos institucionais começam a tratar o produto como se sua autoridade viesse de evidências verificadas.
O objetivo prático não é tornar a IA generativa infalível. Os sistemas atuais não podem garantir isso. O objetivo é projetar o fluxo de trabalho de forma que um erro da IA permaneça como um erro detectável em um rascunho, em vez de se tornar um fato operacional. Os sinais mais claros de um sistema maduro são a proveniência visível da fonte, a corroboração independente para afirmações consequentes, a incerteza explícita, as etapas de revisão registradas e um ponto predefinido no qual os humanos deixam de confiar no caminho gerado e passam a usar um método mais restrito.