Главная
» Новости
»
Отчет американских военных о ложных разведывательных данных, полученных с помощью ИИ: что произошло и почему это важно.
Отчет американских военных о ложных разведывательных данных, полученных с помощью ИИ: что произошло и почему это важно.
Сообщения о том, что американские военные едва избежали опасности, связанной с разведывательным отчетом, подготовленным с помощью ИИ, стали полезным примером решения гораздо более широкой проблемы: генеративный ИИ может ускорить анализ, но скорость — это не то же самое, что подтвержденная точность. В ситуации с высокими ставками тщательно подготовленный ответ может быть опасен, если его источники, предположения и неопределенность не видны тем, кто принимает решения на его основе.
Согласно первоначальному сообщению CNN от 18 сентября 2026 года , в котором со ссылкой на четырех человек, знакомых с ситуацией, во время войны с Ираном в американских вооруженных силах распространялся разведывательный доклад, утверждавший, что китайское судно на Ближнем Востоке перевозит компоненты, связанные с программой создания ядерного оружия. CNN сообщила, что были предприняты приготовления к перехвату судна и что военные самолеты уже находились в воздухе до того, как официальные лица пересмотрели исходный анализ.
Как сообщается, в ходе проверки выяснилось, что чат-бот неверно идентифицировал груз судна. CNN также сообщила, что искусственный интеллект снова использовался для оформления анализа в стандартный формат разведывательного отчета. Этот второй шаг важен, поскольку авторитетное форматирование может создать впечатление большей достоверности слабого анализа, чем он есть на самом деле.
Существуют важные ограничения на то, что известно общественности. CNN заявила, что не может определить, что именно представлял собой ошибочно идентифицированный груз, а также является ли чат-бот коммерческой системой или продуктом правительства. Пентагон и Тихоокеанское командование специальных операций США не предоставили CNN комментариев по этому поводу. Таким образом, на момент публикации этот эпизод представлял собой новостной репортаж, основанный на имеющихся источниках, а не публично обнародованное расследование Министерства обороны или отчет о результатах операции.
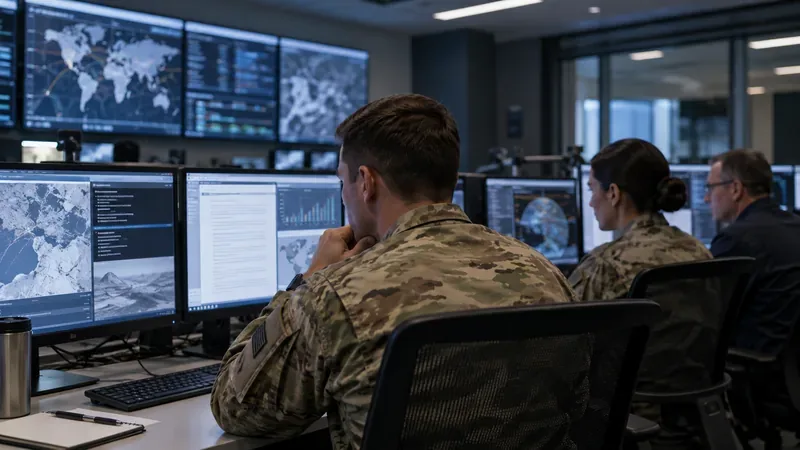
Военные аналитики работают за компьютерными станциями в типичной обстановке операционного центра; изображение дает контекст для анализа результатов машинного анализа, проводимого человеком, и не отражает факт произошедшего инцидента.
Почему произошедший инцидент имеет значение
Непосредственная проблема заключается не просто в том, что система ИИ могла выдать ложное утверждение. Известно, что системы генеративного ИИ выдают уверенные на первый взгляд, но необоснованные результаты, — риск, который Национальный институт стандартов и технологий (NIST) описывает в более широкой категории конфабуляции. В профиле генеративного ИИ NIST это рассматривается как риск, который организации должны активно измерять и контролировать, а не предполагать, что его можно устранить.
Наиболее серьёзная ошибка возникает, когда сгенерированное утверждение проходит через учреждение без достаточного сопротивления. Если же ответ системы преобразуется в привычный формат информации, распространяется по доверенным каналам и обрабатывается до независимого подтверждения, неопределённость модели может исчезнуть, а институциональный авторитет документа возрастёт.
Скорость может сократить время, доступное для скептицизма.
Военные организации ценят скорость принятия решений по вполне понятным причинам. Стратегия Министерства обороны США по внедрению данных, аналитики и искусственного интеллекта на 2023 год прямо связывает ИИ с более быстрыми и качественными решениями, а также ставит обеспечение надежности и ответственное использование ИИ в иерархию своих потребностей. Эти цели совместимы только в том случае, если более быстрое производство сочетается с достаточно надежной проверкой.
Поэтому полезным критерием качества является не вопрос «Насколько быстро ИИ сгенерировал оценку?», а вопрос «Насколько быстро рецензент мог проверить каждое оперативно значимое утверждение?». Если время проверки увеличивается, а время составления документа сокращается, рабочий процесс может выглядеть эффективным, но на самом деле перенаправляет работу и риски на более поздние этапы.
Объединение источников может скрыть источник ошибки.
CNN сообщило, что чат-бот объединил материалы из открытых источников с секретной радиоэлектронной разведкой. Такой синтез может быть ценным, но он также создает проблему происхождения информации. Рецензенту необходимо знать, какой вывод был сделан из какого источника, что было непосредственно замечено, что было выведено путем умозаключений и что было сгенерировано моделью.
Когда эти различия сводятся к единому связному повествованию, рецензент может оказаться не в состоянии определить, отражает ли ключевое предложение исходный фрагмент информации, аналитическую оценку человека или вывод, сделанный искусственным интеллектом. Это особенно опасно, когда утверждение может привести к необратимым последствиям.
Что должен давать высококачественный рабочий процесс, использующий искусственный интеллект?
Наиболее эффективным ответом на подобный сбой является не общее правило, согласно которому ИИ всегда небезопасен. Лучший подход — определить наблюдаемые контрольные точки качества. Следующие проверки упрощают аудит результатов и позволяют более четко определить, когда необходимо изменить рабочий процесс.
Критерий качества
Как выглядит хороший результат
Предупреждающий знак
Когда следует изменить подход
Происхождение
Каждое оперативно значимое требование может быть отслежено до указанных исходных записей, временных меток или потоков сбора данных.
Рецензент видит вывод, но не может определить доказательства, лежащие в его основе.
Прекратите использовать произвольную генерацию формулировок для этого утверждения и перейдите к поиску информации на основе источников или к ручной проверке.
Независимое подтверждение
Наиболее значимые утверждения проверяются по отдельному источнику или аналитическому методу.
Несколько предложений получены либо из одного и того же результата работы модели, либо из одного и того же исходного источника.
Принимать меры следует отложить до получения результатов независимой проверки, если только командир прямо не признает остаточный риск в соответствии с действующими правилами.
Неопределенность
В отчете разделяются наблюдаемые факты, суждения аналитиков, выводы моделей и нерешенные вопросы.
Формулировки являются однозначными даже в тех случаях, когда доказательства неоднозначны.
Перед дальнейшим распространением необходимо потребовать предоставления заявления о достоверности и объяснений причин расхождения результатов.
Человеческий вызов
От рецензента ожидается проверка вывода, а не просто одобрение форматирования.
Роль человека сводится к нажатию кнопки «принять» на продукте, созданном искусственным интеллектом.
Для принятия решений, имеющих серьезные последствия, следует привлечь второго эксперта или провести проверку "красной командой".
Возможность аудита
В журнале регистрируются запросы, версия модели, полученные данные, правки и окончательные утверждения.
Никто не может восстановить, как был сделан этот вывод.
До тех пор, пока цепочка поставок не будет восстановлена, считайте продукт непригодным для использования в ответственных оперативных ситуациях.
Существующие принципы обороны США уже указывают на необходимость таких мер контроля.
Принципы этики ИИ, разработанные Министерством обороны, актуальны, поскольку они подчеркивают ответственность человека, отслеживаемость, надежность и управляемость. В меморандуме Министерства от 2021 года говорится, что персонал должен проявлять надлежащую осмотрительность и осторожность, что методологии ИИ и источники данных должны быть прозрачными и подлежащими аудиту для соответствующего персонала, а возможности должны тестироваться и обеспечиваться в рамках их определенного применения. Исходным документом является меморандум Министерства обороны о внедрении ответственного искусственного интеллекта .
Для автономных и полуавтономных систем вооружения директива Министерства обороны США 3000.09 требует надлежащего человеческого суждения, реалистичного тестирования, надежности, а также прозрачных или подлежащих аудиту источников данных и технологий. Эта директива сама по себе не регулирует работу каждого чат-бота для анализа разведывательной информации, поэтому ее не следует представлять в качестве доказательства того, что описанный рабочий процесс нарушил конкретную политику в отношении вооружений. Тем не менее, она полезна в качестве доказательства более широкой логики безопасности министерства: системы, влияющие на важные решения, должны иметь определенные ограничения, тестирование, надзор и способ остановить работу, когда поведение не заслуживает доверия.
Когда организациям следует прекратить использование генеративной модели и перейти на другие методы?
Практическая политика в области ИИ должна включать четкие условия выхода. Командам следует отказаться от неограниченной генерации, когда система не может продемонстрировать надежное происхождение источника, когда утверждение может напрямую повлиять на применение силы, когда от модели требуется определить идентичность или назначение неоднозначного груза или оборудования, или когда эксперты не могут воспроизвести вывод на основе имеющихся доказательств.
В таких случаях более безопасной альтернативой может быть система, осуществляющая только поиск, которая возвращает соответствующие фрагменты исходного текста, не генерируя новых фактических выводов. Другой вариант — структурированная поддержка принятия решений, в которой модель может систематизировать доказательства, но не имеет права заполнять недостающие факты. Для вопросов, имеющих наиболее серьезные последствия, подходящим методом может быть просто обычный анализ человеком с помощью машины, ограниченной поиском, переводом, транскрипцией или сортировкой документов.
Правильный пороговый уровень зависит от последствий ошибки. Модель, используемая для обобщения логистической записки, может допускать иной уровень остаточной неопределенности, чем модель, результаты работы которой могут повлиять на решение о перехвате, забастовке или эскалации конфликта.
Как определить, действительно ли работают меры защиты?
Одних лишь политик недостаточно, если организации не измеряют результаты. Полезными показателями являются процент важных утверждений с прямыми ссылками на источники, частота обнаружения рецензентами необоснованных утверждений модели, количество отозванных или исправленных отчетов после распространения, среднее время, необходимое для проверки критических утверждений, и частота изменений рекомендаций ИИ после независимой проверки.
Еще один важный сигнал — это разногласия. Если второй аналитик или отдельная модель приходят к существенно иной интерпретации тех же данных, это должно усилить проверку, а не привести к автоматическому усреднению. Разногласия могут выявить двусмысленность, которую в противном случае скрыл бы однозначный ответ.
Качество также следует оценивать в условиях реального давления. Рабочий процесс, который хорошо работает в лаборатории, но дает сбой, когда аналитики спешат, перегружены или работают с неполной информацией, не готов к существенному практическому применению. Релевантным тестом является вся система «человек-машина», а не модель в отрыве от контекста.
Что этот эпизод не доказывает
Сообщения о едва избежанной опасности не доказывают, что все военные системы искусственного интеллекта ненадежны, что генеративный ИИ никогда не следует использовать в разведывательной работе или что проблема была вызвана конкретным поставщиком модели. В публичном сообщении не указывается модель, точный запрос, ошибочно идентифицированный груз, полная цепочка проверки или внутренние правила, которые применялись к аналитику.
Также не устанавливается, как часто возникают подобные ошибки. Без общедоступной базы данных инцидентов, результатов аудита или раскрытого показателя количества созданных с помощью ИИ интеллектуальных продуктов, один эпизод не может служить надежным источником информации о частоте отказов.
Эти ограничения важны, потому что чрезмерная реакция может быть столь же бесполезной, как и недостаточная. Более обоснованный вывод узок: когда ИИ внедряется в аналитический конвейер, имеющий серьезные последствия, качество выходных данных следует оценивать по происхождению, подтверждению, обработке неопределенностей, воспроизводимости и независимой проверке человеком, а не по беглости, скорости или профессиональному форматированию.
Итог
Сообщения об инциденте с ложными разведывательными данными, полученными американскими военными с помощью ИИ, важны, потому что они иллюстрируют тип сбоя, который может произойти в любой организации, работающей в условиях высоких рисков: модель делает необоснованный вывод, программное обеспечение превращает этот вывод в отполированный продукт, и институциональные процессы начинают рассматривать продукт так, как если бы его авторитетность основывалась на проверенных доказательствах.
Практическая цель состоит не в том, чтобы сделать генеративный ИИ непогрешимым. Существующие системы не могут этого гарантировать. Цель состоит в том, чтобы разработать рабочий процесс таким образом, чтобы ошибка ИИ оставалась обнаруживаемой ошибкой чернового варианта, а не становилась оперативным фактом. Наиболее явными признаками зрелой системы являются видимая информация об источнике, независимое подтверждение важных утверждений, явная неопределенность, зарегистрированные этапы проверки и заранее определенная точка, в которой люди перестают доверять сгенерированному пути и переключаются на более ограниченный метод.